In questo articolo esploriamo come e perché la diffusione di task generativi basati su LLM stia influenzando il software development lifecycle. Approfondiamo in particolare i problemi che emergono passando da un Proof of Concept a un prodotto rifinito. Il takeaway principale è un framework specifico per questi use case, l’Evaluation Driven Development, insieme a esempi concreti per implementarlo nel tuo progetto e nel tuo team.
Il value gap
In generale, il software development lifecycle tradizionale può essere semplificato così:
- Requirements Gathering: codifichiamo i problemi del mondo esterno in una serie di requisiti che si possono risolvere per lo più tramite pattern ben noti.
- Build: implementiamo i pattern noti attraverso una soluzione software. Se alcuni requisiti non rientrano in nessun pattern, progettiamo e ingegnerizziamo una soluzione custom che potrà col tempo diventare essa stessa un pattern.
- Test: ci assicuriamo che la soluzione implementata si comporti come atteso dai pattern teorici
- Deploy: forniamo la soluzione software all’end-user e, possibilmente, raccogliamo insight sul valore percepito
Dopo decenni di sviluppo software, oggi applichiamo in larga parte pattern di soluzione a problemi noti, con un certo grado di adattamento basato sui singoli use case. Quello che si fa normalmente è:
- Identificare classi di problemi
- Applicare pattern di soluzione
- Generare un valore di prodotto prevedibile
Immagina un piccolo negozio di biciclette che commissiona un nuovo software di gestione delle forniture. I dipendenti devono consultare le informazioni sulle forniture per il lavoro quotidiano; il proprietario, però, teme che possano modificare gli ordini ai fornitori o altre informazioni critiche. Nel costruire il software, in sostanza:
- Identifichiamo un use case della classe di problemi “Read-Only Accounts”
- Implementiamo una feature di Role-Based Access Control come pattern di soluzione
- Consegniamo un software che garantisce che gli account dei dipendenti non possano modificare gli ordini ai fornitori
In questo modo, il valore consegnato dalla feature è fortemente allineato al valore atteso dall’utente già in fase di sviluppo. Il gap tra valore consegnato e valore atteso dagli utenti è generalmente piccolo, deterministico e controllabile.
Al contrario, questo non vale quando si sviluppano prodotti basati su AI. Questo è un trade-off che accompagna le tecnologie AI: da un lato abilitano feature prima impensabili, dall’altro il gap tra valore consegnato e atteso presenta una varianza maggiore e un comportamento meno controllabile. Non è un aspetto negativo in sé, ma un tratto di cui dobbiamo tenere conto e che dobbiamo controllare.
Un allineamento di valore che si deteriora
Team in tutto il mondo stanno costruendo demo GenAI eleganti e appariscenti. All’inizio l’entusiasmo è alto, il budget è generoso e gli stakeholder portano avanti volentieri i progetti. Nel Proof of Concept (PoC) le feature funzionano bene e la GenAI porta un valore percepito positivamente sia dal team sia dagli utenti.
Poi, scaliamo il PoC sia aggiungendo nuove feature sia aumentando l’utilizzo, finendo per ritrovarci in una sorta di purgatorio che, a differenza del software tradizionale, è particolarmente difficile da lasciare.
Allucinazioni ed edge case
Man mano che il prodotto scala, allucinazioni ed edge case diventano molto più frequenti. Nuove feature introducono nuove allucinazioni. Feature già esistenti ne fanno emergere di nuove semplicemente perché il prodotto viene usato di più. Di conseguenza, l’entusiasmo per il progetto cala rispetto alle demo iniziali.
Il costo dell’iterazione
Iterare non è facile come su un’applicazione tradizionale:
- Costo dei tool: i test LLM-based hanno un costo diretto sul budget (API call)
- La review interna introduce un costo indiretto: analizzare le trace di completion e gli output degli LLM richiede più tempo. Non tutto si può valutare con una metrica, e molti contenuti devono essere letti da persone.
- Il feedback di stakeholder e utenti è più costoso e complesso. Includere nel feedback loop persone non vicine al team interno è impegnativo per via dell’investimento di tempo appena citato.
- Tassa di coordinamento: tutto quanto sopra porta anche a un overhead di coordinamento più volatile e difficile da gestire rispetto ad altri tipi di progetti.
Con il software tradizionale si parte in sordina e l’energia cresce mentre il prodotto scala. Con le app GenAI succede spesso il contrario: il PoC è il picco, e l’entusiasmo tende a scemare dopo, fermando a volte il progetto prima che vada live.
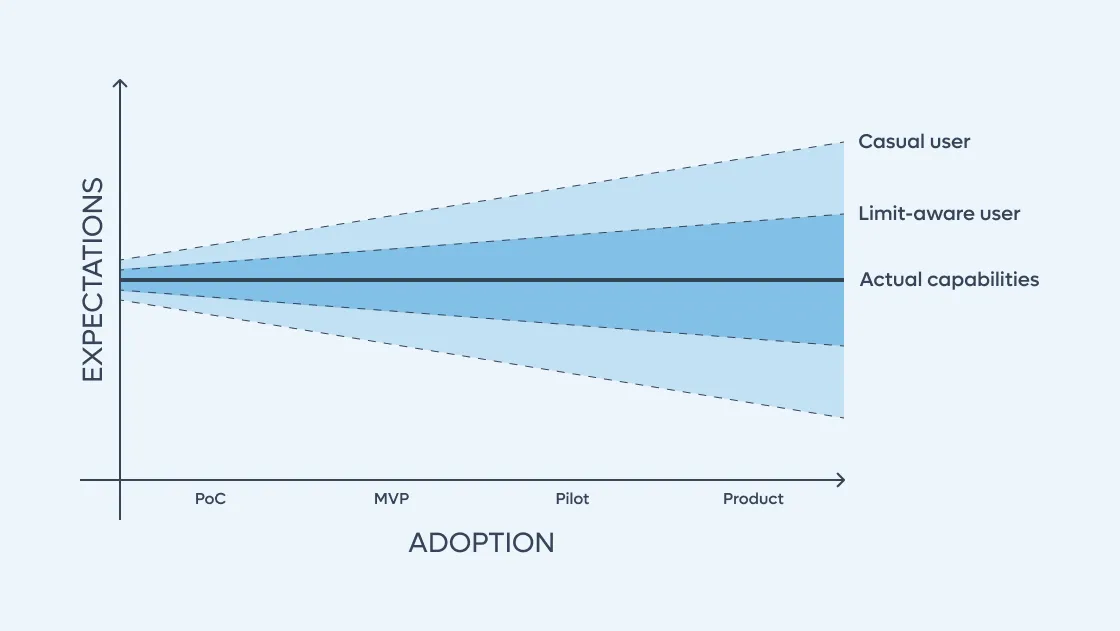
Le conseguenze di queste sfide sono cruciali: l’allineamento tra valore consegnato dalla feature e aspettative dell’utente si deteriora progressivamente. Le feature AI-driven ampliano il gap tra valore consegnato e atteso, che ora è meno prevedibile e sotto controllo. Perché succede?
Le aspettative
L’allineamento tra valore consegnato e atteso può essere negoziabile. Per esempio, se una grande fabbrica commissiona un sistema di Machine Learning Computer Vision ad alte performance per individuare difetti di prodotto, è noto e previsto che il sistema avrà una certa percentuale di confidenza. Potrebbero chiedere un tasso di successo del 90%-95%, aspettandosi che il resto siano errori (falsi positivi o falsi negativi). Il vero problema di allineamento non è solo tecnologico, ma è una combinazione con il target audience (requisiti e aspettative diverse). Oggi stiamo integrando tecnologia AI per end-user che hanno ancora aspettative da software tradizionale. È qui che l’allineamento tra valore consegnato e atteso si deteriora.
È davvero una cosa nuova?
Abbiamo appena visto che scalare un PoC GenAI fino a trasformarlo in prodotto presenta sfide specifiche, diverse da quelle delle app tradizionali.
La maggior parte di queste sfide deriva dal task generativo svolto dagli LLM. È importante notare che non è una peculiarità della tecnologia LLM, ma del task generativo in sé. Infatti incontreremmo le stesse sfide se il task generativo fosse eseguito da una tecnologia diversa (ad esempio, un generatore di stringhe pseudo-random). Allo stesso modo, non avremmo quelle sfide se usassimo gli LLM per un tipo di task diverso, ad esempio un task di classificazione in cui il co-dominio target è limitato e noto staticamente.
Le sfide principali del task generativo degli LLM sono quindi associate a:
- Non-determinismo: secondo la definizione formale, un sistema deterministico fornisce sempre lo stesso output con lo stesso input, senza alcuna variazione casuale. Nel contesto di questo post, invece, il non-determinismo si riferisce al fatto che il comportamento complessivo ad alto livello dell’applicazione è incerto e probabilistico. Anche se i sistemi ML e gli LLM possono essere deterministici per definizione formale, le app costruite sopra di loro risultano in pratica probabilistiche. Chi fa software engineering tradizionale non è abituato a questo e non ha processi di sviluppo pensati per comportamenti di feature probabilistici e incerti.
- Dati non strutturati: il software engineering tradizionale lavora già con dati non strutturati: pensiamo a un parser di PDF. Il punto chiave è la variabilità dei dati non strutturati: oltre un certo grado di variabilità gli LLM diventano necessari. In questo caso, i dati non strutturati vengono processati nella loro forma grezza, invece di codificare/decodificare l’informazione come fa l’approccio tradizionale.
In Buildo abbiamo osservato come il lifecycle di sviluppo dell’AI verticale si differenzi da quello più tradizionale dell’engineering. Nel primo, le sfide descritte sopra vengono affrontate usando framework affidabili.
Il vero problema è che la GenAI, quando è entrata di colpo nei team di engineering tradizionali, è stata affrontata con pratiche convenzionali. Guardando a come i professionisti sviluppano AI verticale, possiamo trovare modi migliori per risolvere queste sfide comuni. Il loro SDLC non sembra un purgatorio.
L’approccio scientifico
Questi professionisti lavorano come scienziati, affidandosi profondamente al metodo scientifico. In pratica,
- Osservano
- Si fanno domande e formulano un’ipotesi
- Conducono esperimenti
- Traggono conclusioni data-driven
…e ripetono il processo.
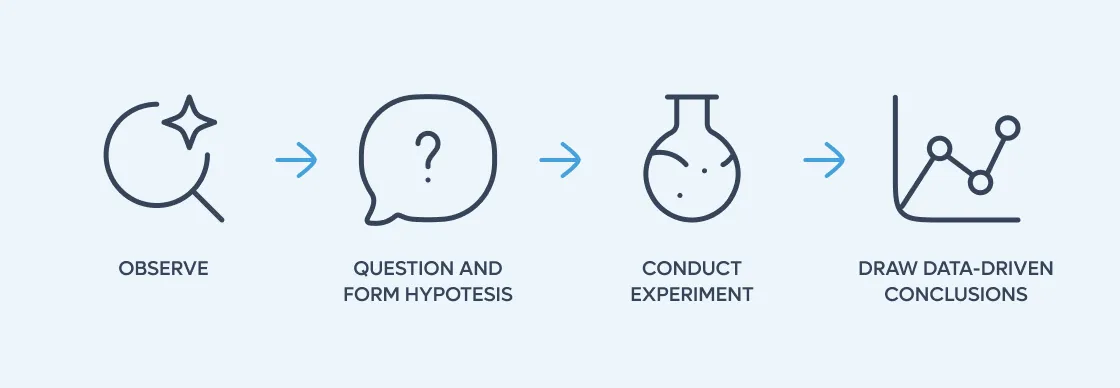
Sembra naive, vero? Sì, ma non staresti lì a osservare come funziona una feature di read-only accounts, formulare un’ipotesi sul comportamento attuale, progettare un esperimento per validarla, eseguirla e trarre conclusioni sul nuovo comportamento. La implementeresti, e magari la testeresti, perché sai già qual è il comportamento atteso.
Al contrario, in un’iterazione scientifica hai solo un’idea vaga del comportamento atteso. Per questo lo metti in discussione e formuli un’ipotesi da valutare tramite sperimentazione. La GenAI non è diversa. Possiamo applicare i fondamentali del metodo scientifico per uscire dal purgatorio del PoC. Chiamiamo questo approccio, nel contesto GenAI, Evaluation Driven Development.
Evaluation Driven Development
Supponiamo di aver già sviluppato un PoC solido:
- Supera il vibe check, se la cava bene in una manciata di test e per lo più rispetta le aspettative
- Presentare le demo internamente o agli stakeholder genera forte entusiasmo, soprattutto con un budget interessante in gioco
- Non c’è ancora nessuna ottimizzazione: scelta del modello, fine-tuning e altre rifiniture sono ancora intatti
Nei paragrafi che seguono ti accompagniamo passo per passo nel processo di costruzione di un EDD strutturato. Quando sviluppiamo progetti AI in Buildo, l’EDD è la nostra prima scelta. Lo vedremo in azione su un progetto che stiamo sviluppando in ambito finanziario: un Chat Assistant multi-agent.
Come prerequisiti, assumiamo che gli obiettivi e i target comuni del progetto siano già definiti: personas, scenari, definizioni di successo e criteri di misurazione sono tutti stati stabiliti, esattamente come in un progetto software tradizionale.
Synthetic data
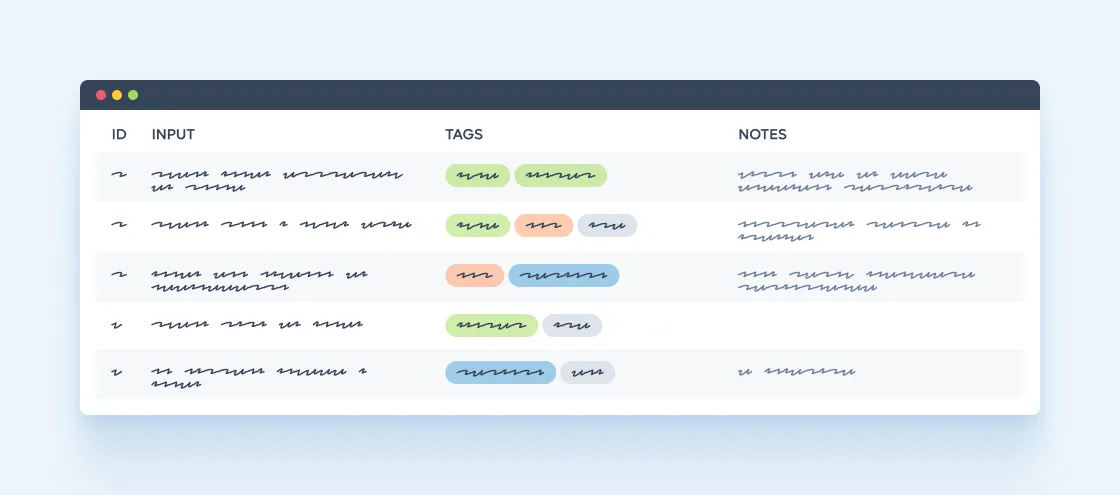
La prima cosa di cui preoccuparci sono i dati. All’inizio dovremmo raccogliere quanti più dati organici possibile per eseguire il modello su use case reali. Per esempio, nel caso di un AI chat assistant, significa raccogliere domande e risposte umane reali.
Questo task può essere costoso e time-consuming. In ambito B2C può essere difficile entrare in contatto con gli end-user e raccogliere dati efficaci. In ambito B2B, invece, gli stakeholder fanno probabilmente da intermediari degli end-user, introducendo bias. Inoltre, potrebbero non essere sempre disponibili. Questi problemi sono fortemente disallineati con le esigenze iniziali del progetto, in particolare quella di iterare in fretta per validare il prodotto.
Per questi motivi, generare i dati è l’approccio più efficace. L’obiettivo è raccogliere dati sufficienti per eseguire gli use case e validare le feature esistenti. I dati sintetici dovrebbero riflettere il più possibile use case reali; la generazione dovrebbe basarsi su dati organici quando disponibili. Un’alternativa ancora migliore è includere un Subject Matter Expert (SME) nel processo, per generare o validare le entry sintetiche. Coinvolgere domain expert negli scenari che vogliamo simulare porta costantemente valore.
Nel nostro progetto AI Assistant, i dati sono le domande testuali degli utenti a professionisti del mondo finanziario. Per prima cosa abbiamo raccolto sample organici da email reali fornite dagli SME. Poi, il team ha scritto manualmente altre entry, provando a muoversi nel dominio finanziario del progetto. Infine, abbiamo generato la parte più significativa delle entry del dataset usando ChatGPT, con prompt focalizzati sul dominio. Purtroppo nella fase iniziale non siamo riusciti a includere sistematicamente un SME nel progetto. Di conseguenza, il dataset aveva inizialmente dei bias e una leggera varianza, come era prevedibile.
Nota che qui stiamo ancora parlando dei dati su cui far girare il modello, cioè le query degli utenti, e non dei dati che validano l’output del modello, cioè le risposte dell’assistant.
Guarda i tuoi dati
Ora siamo in grado di eseguire la nostra applicazione LLM-based su una moltitudine di casi (sintetici o organici) per vedere come si comportano le feature. Dobbiamo iterare, analizzare il comportamento dell’app e dare feedback sui cambiamenti basandoci sui nostri insight.
È qui che entra in gioco il celebrato slogan “Look At Your Data”. I cambiamenti all’applicazione devono basarsi su insight oggettivi ricavati dai dati analizzati. Questo significa che:
- Dobbiamo avere un sistema per tracciare i dati di ogni caso
- Dobbiamo analizzare i dati e fare deduzioni oggettive
Di conseguenza, abbiamo bisogno di:
- Impostare un sistema di observability
- Usare il cervello
L’observability, cioè logging e monitoring, è la base del nostro feedback loop. Prima la mettiamo in piedi, meglio è. Esistono tanti tool di observability che strumentano l’applicazione in poche righe di codice, forniscono storage in cloud e hanno dashboard UI pulite.
Una volta messi in piedi, guardiamo i dati, facciamo cambiamenti e ripetiamo. All’inizio vogliamo concentrarci solo sul prompt engineering, lasciando da parte altri aspetti come la scelta del modello o il fine-tuning. Il prompt engineering impatta in modo significativo sull’efficacia del prodotto con un effort minimo, mentre altri cambiamenti rifiniscono la qualità a costi più alti. È un classico caso della regola di Pareto in azione.
In Buildo abbiamo usato Logfire per strumentare il nostro AI Assistant in pochi minuti. Durante la fase di evaluation ispezioniamo le trace degli LLM e vediamo rapidamente come le modifiche locali impattano sull’output. Inoltre, abbiamo segregato l’evaluation del nostro sistema multi-agent per concentrarci sull’esecuzione e analisi dei test case per un singolo agent alla volta. Infine, all’apertura di una PR, una pipeline GitHub Actions esegue tutti i casi di evaluation, così i reviewer possono vedere come le modifiche al codice proposte impattano sul comportamento end-to-end dell’Assistant.
A differenza degli unit o integration test, eseguire gli evaluation test ora ha un costo diretto in termini di soldi e tempo. Non dovrebbe essere una priorità per il successo del progetto, ma può incidere pesantemente su una parte del budget. In questo caso, interventi a basso effort possono fare la differenza. Per esempio, abbiamo configurato il job di evaluation nella pipeline in modo che venga eseguito manualmente tramite uno specifico commento sulla PR (/evals <agent_name>), invece di triggerare su eventi git come nuovi commit. Nel nostro caso questo ha evitato di far girare automaticamente test costosi per ogni commit a grana fine pushato su un branch di PR, cosa frequente nel nostro workflow di sviluppo.
Ground Truth
A questo punto abbiamo definito un processo di iterazione per fare cambiamenti efficienti basati su insight data-driven.
Però come facciamo a sapere che quegli insight siano corretti? Cosa sappiamo davvero del problema?
Ricordando il task “Draw data-driven conclusions” dell’approccio scientifico, è essenziale sottolineare il fatto che viene condotto da persone esperte del loro campo. Il task di esperimento può essere eseguito da persone diverse, ma le conclusioni tratte sono quelle di chi guida lo studio (gli scienziati).
Facendo un paragone, noi engineer stiamo eseguendo esperimenti e traendo conclusioni su un dominio di cui probabilmente non siamo esperti. Il punto è che possiamo trarre conclusioni e fare cambiamenti, ma come possiamo essere sicuri di essere sulla strada giusta e di puntare nella direzione corretta?
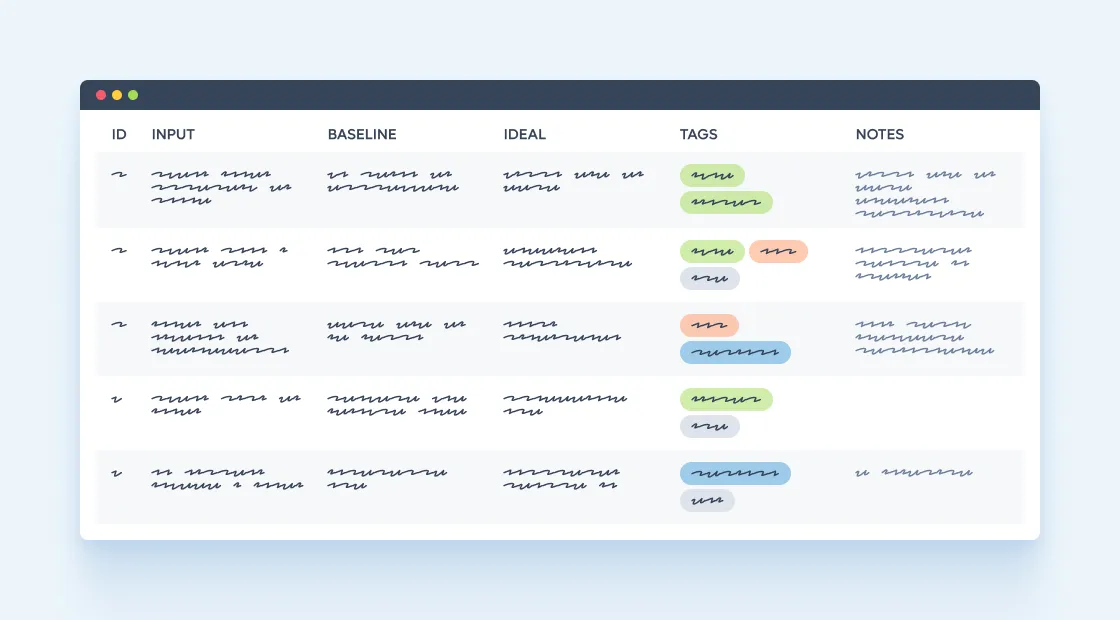
Dobbiamo quindi stabilire un target da puntare durante le iterazioni. Al momento abbiamo un dataset composto da queries (organiche o sintetiche) e actual answers del modello corrente (baseline). Ora aggiungiamo una nuova colonna: expected answers. Sono le risposte ideali e di alta qualità alle query a cui la nostra applicazione LLM-based deve puntare nel lungo termine. Chiamiamo questa versione del dataset Ground Truth: la North Star del nostro progetto. I cambiamenti devono essere guidati e giustificati dai contenuti della Ground Truth.
Questo non significa che la Ground Truth debba essere un riferimento statico e immutabile per l’intero progetto. Come qualunque altra parte dell’applicazione, ha bisogno di cambiamenti e aggiornamenti man mano che validiamo le feature o ne aggiungiamo di nuove. Deve essere un riferimento all’interno del ciclo di iterazione, e i suoi contenuti possono e devono essere aggiornati nell’iterazione stessa.
Raccogliere le expected answer presenta gli stessi problemi di raccogliere le query: mancanza di dati sufficienti, poca varianza, e costi e tempi elevati. Allo stesso modo possiamo usare dati sintetici, ma questa volta l’obiettivo è avere entry di alta qualità per il lungo termine, invece che entry per iniziare a lavorare su un’ampia varietà di use case.
Per questo motivo, nella costruzione della Ground Truth è obbligatorio coinvolgere i domain Subject Matter Expert (SME). Possono aiutarci a creare le expected answer da zero (più costoso, ma più veloce) oppure a validare le nostre proposte umane o generate (meno costoso, ma richiede più iterazioni).
Avere una Ground Truth è essenziale: prima la implementiamo, meglio è, perché ci permette di iterare su use case che somigliano molto a quelli reali. Il trade-off è il costo del coinvolgimento degli SME, sia in termini di budget sia di tempo.
Nel nostro progetto in Buildo abbiamo prima raccolto expected answer organiche da email reali fornite dagli SME, ma erano troppo scarse: puntavamo a una ground truth di circa 100 entry, mentre le email fornite erano solo poche. Analogamente a come abbiamo generato le query, il team ha scritto manualmente nuovi sample e usato ChatGPT per il resto. Questa volta però abbiamo validato tutti i sample insieme agli SME, iterando sui contenuti e sul formato. Abbiamo iniziato questo task il prima possibile, mentre sviluppavamo le feature dell’agent, in modo da poter iterare efficacemente su dati di valore una volta che il PoC avesse iniziato a decollare.
Evaluation Harness
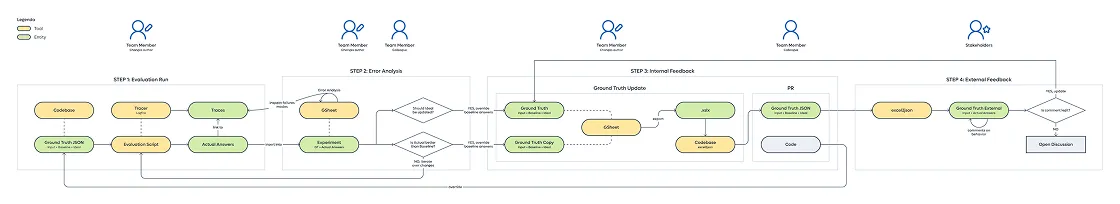
Il processo e i componenti che abbiamo delineato formano insieme l’Evaluation Harness:
- Ground Truth: a cosa puntare attraverso gli esperimenti
- Observability: come guardiamo i risultati dei nostri esperimenti
- Feedback Loop: il processo che ci permette di migliorare il prodotto
Ricorda che l’Evaluation Harness deve avere il proprio feedback loop. Il prodotto e l’Eval Harness possono crescere in modo indipendente; però, nuovi findings e miglioramenti in un feedback loop probabilmente impattano (positivamente) sull’altro.
Analogamente a quanto succede con le iterazioni di prodotto, i feedback loop dell’Eval Harness possono andare dal team interno fino agli end-user, con step intermedi come stakeholder e SME. Di solito, più l’iterazione è vicina, più è economica e meno efficace. Più è lontana dal team interno, più è efficace e costosa.
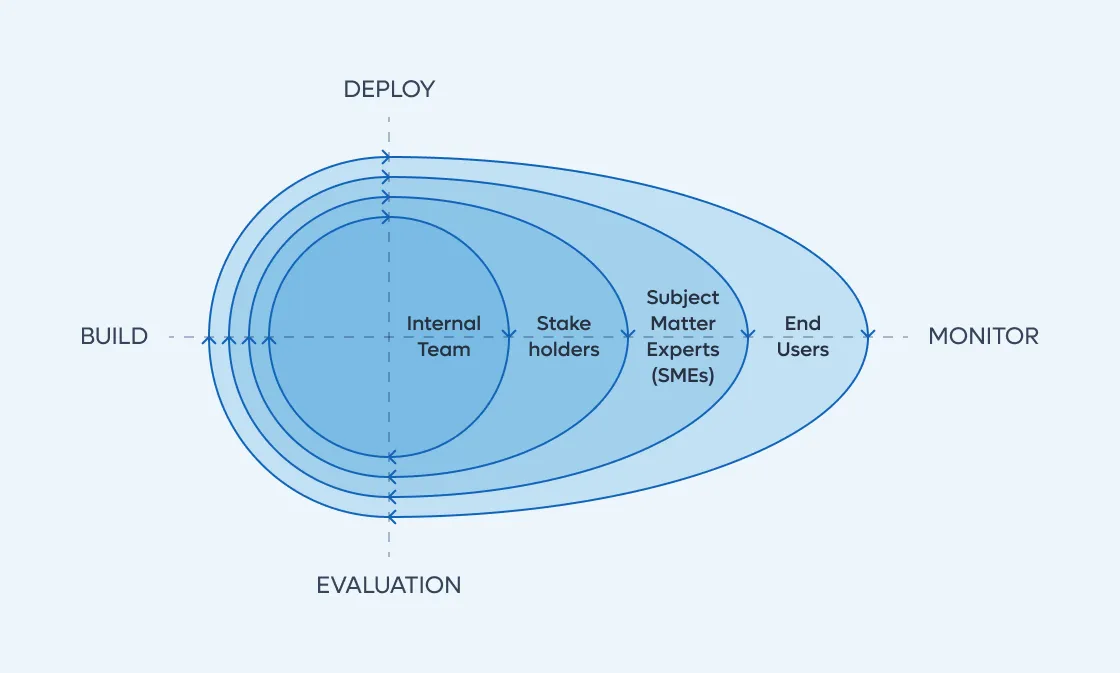
Bilanciare raggio e frequenza delle iterazioni è ciò che fa dare il meglio al prodotto, mettendo in equilibrio budget di progetto e qualità del prodotto.
Qui sotto una panoramica di come abbiamo implementato il processo per lo use case di progetto descritto in precedenza. Clicca sull’immagine per ingrandirla.
Takeaway
I team di engineering che stanno trasformando PoC LLM-based in prodotti dovrebbero ricordarsi che:
- L’AI generativa introduce nuove sfide. La natura della tecnologia influenza pesantemente il gap tra valore atteso e valore fornito in fase di design.
- Non sono problemi nuovi: gli scienziati sono abituati a queste sfide e hanno già framework affidabili per lavorare in modo sistematico con questa tecnologia. Gli engineer dovrebbero prendere ispirazione dall’approccio scientifico.
- L’approccio scientifico, applicato alle applicazioni LLM-based, è ciò che chiamiamo Evaluation-Driven Development. Impostare un framework centrato sul valutare rapidamente e iterativamente il prodotto è fondamentale per creare un prodotto di alta qualità.
- Un Evaluation Harness è lo strumento centrale per implementare un buon processo di Evaluation-Driven Development. Si compone di un dataset di Ground Truth, un framework di observability e un feedback loop veloce ed efficiente, sia interno sia esterno.