Con l’introduzione delle tecnologie GenAI, i team che sviluppano prodotti digitali in tutto il mondo stanno sfruttando le ultime capacità dei modelli per creare esperienze utente migliori. Alle nuove opportunità si affiancano però sfide nuove e note: requisiti non funzionali come scalabilità, tempi di esecuzione costosi e chiamate API costose sono ormai comuni, anche per progetti e team più piccoli. In questo articolo condividiamo la nostra esperienza più recente nell’affrontare queste problematiche, concentrandoci sull’adattamento dei processi e sulla scelta dello strumento giusto: Prefect.
Le sfide di un progetto GenAI
Il vaso di Pandora: indeterminismo
Per indeterminismo intendiamo che, alla fine, non puoi essere certo dei risultati del tuo programma basato su AI. È possibile — e consigliabile — aumentare il livello di fiducia nei risultati usando, ad esempio, suite di test ad hoc del tipo LLM-as-judge (come DeepEval), test unitari di base e revisioni da parte di esperti umani. Tuttavia, la fiducia non può essere garantita per progettazione, e diventa anche una questione di costi: più vuoi essere sicuro, più ti costa.
Ci sono costi diretti dovuti alle chiamate API aggiuntive verso LLM-as-a-Service o alla manutenzione di infrastrutture per modelli LLM personalizzati. Ci sono anche costi indiretti per progettare, implementare e mantenere metriche ben definite per il proprio LLM-as-a-judge, che in generale sono più complesse e soggette a errori rispetto ai test unitari. Il fattore costo non può essere ignorato, perché ora affrontiamo queste sfide anche in team più piccoli e in progetti dove i vincoli di budget possono essere una preoccupazione primaria.
Per questo motivo, osservabilità, ispezione e gestione degli errori diventano essenziali per il successo di un progetto. Consentire al team fin dall’inizio di fare debug e ispezionare il comportamento del programma basato su AI offre un valore significativo nel medio-lungo termine.
Dati, dati e ancora dati
L’uso della GenAI comporta spesso la gestione di grandi quantità di dati e dipendenze da fornitori esterni, con conseguenti chiamate API costose, gestione complessa dei dati e calcoli che richiedono molto tempo. È quindi necessario strutturare il software in moduli data-driven e/o domain-driven per consentire:
- Loop di sviluppo separati ed esecuzioni isolate
- Caching all’interno e tra i moduli
- Esecuzione ottimizzata tramite elaborazione parallela
- Fallimenti circoscritti e strategie di retry isolate
Strutturando l’applicazione in maniera data-driven (o domain-driven), i team possono differenziare i loop di sviluppo. Questo aiuta a disaccoppiare il carico di lavoro all’interno del team , permettendo a ogni membro di eseguire il proprio modulo senza subire i tempi di calcolo e i costi degli altri moduli. Per farlo, le dipendenze dei moduli devono essere messe in cache o simulate (mock). Nulla di nuovo rispetto alle pratiche standard di ingegneria del software; tuttavia, queste strategie diventano ora essenziali per ridurre i costi, poiché ogni modulo può richiedere calcoli intensivi o routine di recupero dati.
Aspettative nel mondo reale
Dal punto di vista della governance, allineare le aspettative sui deliverable basati su AI è intrinsecamente complesso. Che si tratti di un cliente o di un utente finale, stabilire aspettative chiare per l’output di un LLM è più difficile. Nel software deterministico, requisiti funzionali specifici e user experience possono essere concordati più facilmente. I risultati possono anche essere anticipati con mockup a bassa o alta fedeltà, rendendo semplice confrontare le aspettative con i risultati finali. Nei progetti GenAI, invece:
- È più difficile anticipare il risultato di contenuti generati dall’AI.
- I contenuti possono evolvere nel tempo entro certi limiti.
- I casi limite sono meno prevedibili e più impattanti, e comprendono una gamma più ampia di comportamenti inattesi.
Inoltre, in contesti specifici di dominio, gli utenti tendono ad avere aspettative ancora più elevate per i contenuti generati dall’AI, perché sono abituati a output di alta qualità e altamente specializzati. Si pensi a documentazione medica, report finanziari o consulenze ingegneristiche.
Le sole soluzioni tecniche non possono affrontare queste sfide. È necessario stabilire una governance adeguata, con processi ben allineati, per mitigare i rischi di aspettative disallineate. I consumatori devono essere informati su ciò che è fattibile e sul grado di variazione possibile, mentre i produttori devono fornire in anticipo informazioni dettagliate tramite indagini di prodotto e PoC.
Supportare i processi con strumenti ad hoc
Vogliamo condividere come abbiamo affrontato le sfide descritte in precedenza usando un caso reale. In sintesi, le caratteristiche principali del progetto sono:
Generazione di report testuali — L’obiettivo è generare un grande volume di report di testo (una pagina ciascuno), il che comporta un alto livello di indeterminismo.
Dominio finanziario — È richiesto un alto grado di specificità nel linguaggio, nel tono e nella struttura del testo. Inoltre, i dati numerici precisi sono obbligatori.
Grandi quantità di dati — diverse fonti di dati strutturati (es. performance, dati di portafoglio) e non strutturati (es. notizie di mercato) devono essere interrogate ed elaborate per generare i report finali.
Diversi prodotti finanziari — L’ambito del progetto include decine di prodotti finanziari, i loro comparabili e i relativi indici. Inoltre, i report sono generati in più lingue e per diversi orizzonti temporali di riferimento, con conseguenti costi computazionali ed economici elevati.
Abbiamo trovato in Prefect lo strumento giusto per collegare i nostri processi all’implementazione nel codice. Prefect è un motore di workflow in stile Python progettato per creare, distribuire ed eseguire pipeline. Si adatta bene a scenari che coinvolgono grandi quantità di dati, elaborazione e calcolo offline.
Segmentazione del dominio con flussi differenziati
La prima cosa che abbiamo fatto è stata scomporre il contenuto degli esempi di report testuali. Ci siamo concentrati sul separare i contenuti in base alle informazioni del dominio finanziario, assicurandoci che i dati necessari per ciascuna parte dell’output fossero il più possibile disaccoppiati dalle altre parti.
Questa scomposizione ci ha permesso di progettare i moduli software in base a dipendenze domain-driven e data-driven. Di conseguenza, i membri del team hanno potuto sviluppare ogni modulo in modo indipendente.
Prefect consente di progettare un workflow usando flussi (flow) e task. I flussi possono essere annidati, mentre i task sono l’unità di lavoro più piccola.
Abbiamo mappato il nostro processo di generazione del testo in flussi allineati alla segmentazione dei moduli. Questo ha reso semplice ed economico eseguire flussi isolati (cioè sotto-contenuti). I membri del team potevano configurare quali flussi eseguire e specificarne i parametri, permettendoci di ottimizzare i costi di sviluppo e di calcolo.
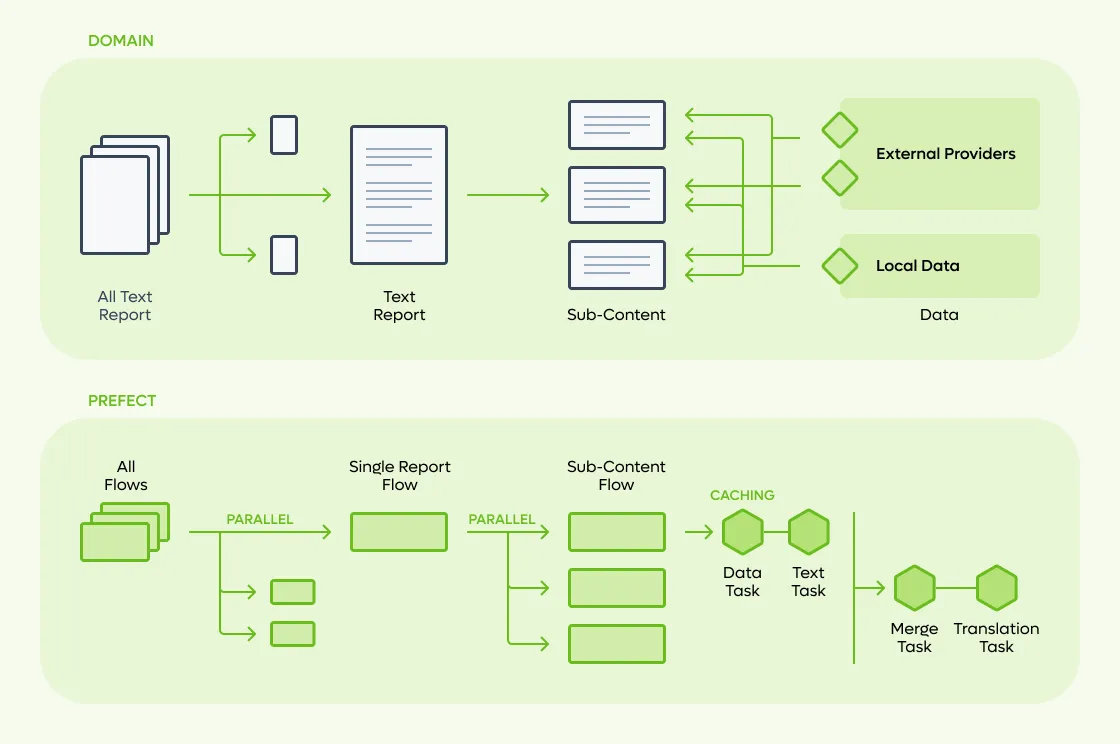
Oltre ai benefici organizzativi tradizionali, abbiamo anche ridotto notevolmente i costi. I membri del team potevano generare sotto-contenuti senza dipendere da dati esterni, chiamate API o tempi di calcolo di altri moduli.
In fase di deployment, configurare le generazioni periodiche (ad es. settimanali) è stato semplice come impostare un trigger tramite una RRule. Il motore di Prefect ha gestito errori e retry con un tracciamento dettagliato, assicurando che scalare la generazione a centinaia di report rimanesse sicuro e sotto controllo.
Feedback e tracciamento con gli Artifacts
Abbiamo sfruttato la funzionalità Artifacts di Prefect per supportare un ciclo di feedback continuo, il feedback umano e il tracciamento storico. Gli Artifacts sono output persistenti progettati per essere consultati dalle persone.
I dati di input trasformati in markdown, i prompt e gli output vengono memorizzati come artifact, permettendo al team di ispezionare facilmente le esecuzioni di generazione per scopi di debug e revisione.
@task(name="Get Data", task_run_name="Get Data {year}-{month}")
async def get_data(self, year: int, month: int):
    # Business logic...

    rows = [row.to_dict() for index, row in df.iterrows()]
    await create_table_artifact(
        key=f"{year}-{month}-data",
        table=rows,
        description="...",
    )
Inoltre, artifact intermedi e più granulari sono stati utilizzati per la validazione dei dati (pre-generazione) e per l’auditing dei dati (durante la generazione).
Abbiamo trovato negli Artifacts uno strumento di osservabilità e ispezione a misura di persona : non efficiente in termini di quantità, ma molto prezioso in termini di qualità. Sulla base della segnalazione di un collega o del feedback di un utente, gli sviluppatori potevano controllare risultati intermedi e finali con pochi semplici click.
Ciclo di feedback continuo
Il rischio di aspettative divergenti era una preoccupazione primaria. Lo abbiamo mitigato istituendo fin dall’inizio un ciclo di feedback periodico e formale con gli utenti finali.
Un esempio specifico che ha beneficiato di questo approccio è stato il lessico e la costruzione delle frasi. Fin dalle prime versioni dei contenuti parziali, gli utenti hanno segnalato che acronimi, gergo finanziario e struttura del testo non erano ben allineati ai report scritti dalle persone. Gli utenti erano abituati a una formulazione diversa da quella appresa dall’LLM.
Integrando il feedback iniziale , siamo riusciti a implementare soluzioni specifiche fin dal principio, assicurandoci che si propagassero senza sforzo e senza costi aggiuntivi ai sotto-contenuti ancora da implementare. In questo caso la soluzione ha comportato la creazione di un dataset per il fine-tuning e la fornitura all’LLM di istruzioni lessicali ben definite e mappature di dizionari, insieme a routine deterministiche di post-generazione.
Feedback umano
Aggiornare i prompt per migliorare o correggere i risultati senza accorgersi degli effetti collaterali indesiderati è facile. Nel nostro caso era comune riscontrare problemi specifici con determinati prodotti finanziari o con parti specifiche dell’output, e correggerli spesso introduceva nuovi problemi in altri prodotti, a volte senza che ce ne accorgessimo subito.
Il campo del testing sta evolvendo rapidamente, con nuove soluzioni che emergono per affrontare le sfide introdotte dall’AI. LLM-as-a-judge è un approccio molto diffuso in cui un LLM valuta la risposta di un altro LLM.
Abbiamo sviluppato una suite di test usando DeepEval per valutare regressioni e qualità dell’output. Per ridurre i costi abbiamo riutilizzato gli Artifacts già generati per le stesse modifiche al codice, invece di generare nuovi output da valutare.
subcontent_generic_phrases = GEval(
    name="Avoid generic phrases",
    evaluation_params=[LLMTestCaseParams.ACTUAL_OUTPUT],
    evaluation_steps=[...],
    threshold=0.2,
)

targets = read_artifacts(id)

test_cases = [
    LLMTestCase(input="", actual_output=target)
    for target in targets
]

dataset = EvaluationDataset(test_cases=test_cases)

@pytest.mark.parametrize("test_case", dataset)
def test_subcontent(test_case: LLMTestCase):
    assert_test(test_case, [subcontent_generic_phrases])
È stato però difficile determinare la qualità complessiva dei deliverable solo attraverso i test automatizzati. Progettare metriche precise che si allineino pienamente alle aspettative degli utenti è complesso e non sempre fattibile.
Alla fine, il feedback umano su un campione di output finali resta essenziale. I test automatizzati possono comunque guidare le persone nella selezione degli output “più problematici” da revisionare. Integrare i test automatizzati con un processo di revisione umana in due fasi è estremamente prezioso, sia interno sia esterno. Durante la fase di sviluppo della funzionalità abbiamo condiviso iterazioni progressive dell’output finale per la revisione interna. Poi ci siamo affidati al ciclo di feedback continuo descritto in precedenza per una revisione esterna e ulteriori iterazioni.
La maggior parte delle volte finivamo per aggiornare test già superati sulla base del feedback umano: i deliverable AI evolvono, e con loro le metriche di valutazione.
Tracciamento storico
La segmentazione del dominio, i cicli di feedback continui e il feedback umano richiedono un approccio sistematico per tracciare dati di input, prompt e output. Per valutare correttamente l’avanzamento degli output testuali finali è necessario confrontare continuamente le nuove modifiche con quelle precedenti. Questo è cruciale quando si gestiscono output di testo di grandi dimensioni, come nel nostro caso.
Ciò che ci ha aiutato di più è stato definire un processo e una struttura chiari per memorizzare le informazioni ai fini del workflow di sviluppo. Abbiamo usato la funzionalità Artifacts di Prefect per conservare dati di input, risultati intermedi e output finali come report markdown. Dopo un’esecuzione del workflow di sviluppo, gli sviluppatori potevano verificare facilmente come le nuove modifiche avessero influenzato l’intera pipeline. Inoltre gli artifact generati erano facili da condividere, permettendo ai membri del team di confrontarsi e rendendo più semplice la revisione delle modifiche.
Disporre di uno storico di (data, prompt, output) ci ha aiutato a identificare con precisione quali modifiche avessero avuto impatto su determinati output. Questo ci ha permesso di annullare o aggiornare le modifiche in base al feedback esterno, anche quando arrivava in cicli di revisione successivi.
Caching: ottimizzazione dei costi e condivisione dei dati
Prefect è progettato tenendo conto del caching, per evitare di ricalcolare lo stesso task quando l’output resta invariato in base ai valori dei parametri. Nel nostro caso questo è stato essenziale per due motivi principali:
- Ridurre al minimo il recupero di grandi quantità di dati e limitare il più possibile le chiamate API costose.
- Consentire la condivisione dei dati tra flussi “fratelli” diversi: ad esempio, report di prodotti finanziari differenti potrebbero richiedere il recupero delle stesse informazioni di base.
In primo luogo, dovevamo iterare su logica di business e prompt che si appoggiavano a grandi quantità di dati, come metriche di performance, notizie e composizioni di portafoglio. I dati cambiano nel tempo, ma recuperarli a ogni esecuzione è inutile quando si aggiornano parti che non ne dipendono. Implementando il workflow pensando al caching di Prefect, evitare recuperi di dati non necessari diventa semplice e conveniente.
In secondo luogo, poiché la segmentazione in moduli può comunque comportare un certo grado di dipendenze tra dati, il caching di Prefect offre un modo diretto per condividere dati tra moduli. Anche se può sembrare una scelta poco ortodossa, abbiamo scoperto che sfruttare la cache su disco è un modo molto semplice per evitare recuperi di dati inutili tra task diversi. Per fortuna il caching di Prefect si comporta allo stesso modo, senza sforzi aggiuntivi, anche quando viene usato tramite un Docker work pool, quindi è utilizzabile in ambienti diversi, incluso uno scenario di produzione.
Ecco un esempio di come configurare il caching per un task costoso:
@dataclass
class CustomCachePolicy(CachePolicy):
    def compute_key(self, inputs: dict[str, Any], **kwargs) -> Optional[str]:
        hashed_inputs = {}
        inputs = inputs or {}

        if not inputs:
            return None

        for key, val in inputs.items():
            if key in custom_list:
                hashed_inputs[key] = val

        return hash_objects(hashed_inputs)

@task(persist_result=True, cache_policy=(TASK_SOURCE + CustomCachePolicy()))
async def get_expensive_data(arg: dict):
    # Business logic ...
    return ...
Abbiamo sfruttato l’API delle cache policy personalizzate di Prefect: calcoliamo la chiave di cache solo per un insieme selezionato di chiavi dell’oggetto argomento. Inoltre, una CachePolicy personalizzata può supportare il caching anche in presenza di argomenti non serializzabili. Più flussi diversi che invocano lo stesso task con lo stesso input produrranno una lettura da disco invece di ricalcolare tutti i dati in base alla chiave modificata. Questo ci ha aiutato a evitare una grande quantità di chiamate API costose tra prodotti finanziari diversi.
Logging
Prefect mette a disposizione le proprie utility di logging per monitoraggio, troubleshooting e auditing. Rispetto alla revisione degli Artifacts, abbiamo trovato il logging utile per l’osservabilità dell’orchestrazione piuttosto che per l’ispezione di dati e output.
Rate limit
Quando generiamo report testuali ci affidiamo a più provider per recuperare grandi quantità di dati. I provider hanno tipicamente dei rate limit, sia in termini di frequenza sia di utilizzo complessivo. Un caso d’uso tipico implementato in Prefect prevede diverse esecuzioni parallele, il che significa inviare molte chiamate API a provider esterni in poco tempo.
Prefect fornisce utility globali per concorrenza e rate limit, che permettono di impostare lock in punti specifici dell’applicazione per evitare che le chiamate API superino il limite. Questo è stato estremamente utile per evitare blocchi temporanei del provider sul client richiedente.
Creare un limite di concorrenza per un task in Prefect è semplice come eseguire
prefect concurrency-limit create get_data 50
mentre impostare un limite globale
prefect global-concurrency-limit create -l 1 --slot-decay-per-second 1 custom-limit
permette di attendere lato client in qualsiasi punto del codice
@task(name="Get Data")
def get_data(year: int, month: int):
    # Business logic...

    await rate_limit("custom-limit")
    # Provider API call...
    # Process response...
Conclusione
I progetti basati su Generative AI portano sia nuove sfide sia quelle comuni tipiche dei prodotti su larga scala. Per il successo di un progetto, anche i team piccoli devono affrontare sistematicamente queste sfide attraverso governance, processi e strumenti ad hoc. La flessibilità è fondamentale: progettare strategie ad hoc per il proprio caso d’uso e dominio è tipicamente una mossa vincente , anche quando contraddice le best practice.
In Buildo stiamo evolvendo i nostri processi per adattare metodologie e workflow alle esigenze dei progetti GenAI: scegliere lo strumento giusto fa la differenza.
Abbiamo trovato in Prefect lo strumento giusto per supportare i nostri processi interni e migliorare i nostri deliverable. Gli autori di Prefect offrono ora anche ControlFlow, orientato alla GenAI e pensato specificamente per le esigenze di progetto discusse in questo articolo: valuteremo sicuramente questa opzione per i progetti futuri in questo ambito.