Negli annali dell’innovazione tecnologica, febbraio-marzo 2023 segna senza dubbio una tappa di notevole importanza nei campi dell’Artificial Intelligence e del Software Engineering. In quei mesi si sono registrati progressi straordinari nell’AI generativa, tra cui l’introduzione di Large Language Model (LLM) all’avanguardia come GPT-4 di OpenAI e LLaMA di Meta. Questi LLM sono in prima linea nell’innovazione e puntano a rivoluzionare diversi aspetti dello sviluppo di software web, dall’ottimizzazione dei workflow interni alla creazione di funzionalità di prodotto prima irraggiungibili a causa di vincoli economici o di complessità.
La nuova ondata di tecnologie LLM ha aperto la strada a opportunità senza precedenti, aumentando considerevolmente velocità, efficienza e sofisticazione delle nostre soluzioni software.
In Buildo vediamo l’arrivo degli LLM non solo come un ulteriore salto tecnologico, ma come uno strumento strategico per far evolvere la nostra software house in due direzioni:
- Integrare funzionalità basate su AI nei nostri prodotti, offrendo agli utenti finali capacità prima irraggiungibili
- Sfruttare strumenti basati su AI per ridurre il “rumore” intorno allo sviluppo, così da poterci concentrare maggiormente sugli aspetti qualitativi legati al fattore umano.
Questo articolo si concentra su come stiamo affrontando il primo obiettivo.
Architetture emergenti basate su LLM: la nuova arma dello sviluppo software
L’arrivo degli LLM ha creato l’esigenza di integrare le loro capacità nel software tradizionale, e non solo di usarli come strumenti per l’utente finale. Da qui sono nate le architetture emergenti intorno agli LLM: come ogni altra tecnologia, hanno design pattern, linee guida e best practice dedicati.
Queste architetture forniscono un framework per interagire con gli LLM scomponendo e isolando le responsabilità. Il concetto chiave, chiamato In-context learning, consiste nel controllare un LLM pronto all’uso tramite prompting avanzato, dati specifici per il caso d’uso e logica di business.
L’interazione base con un LLM generico consiste in una lista finita di messaggi (chat) tra utente e modello, con informazioni di contesto. Purtroppo la chat complessiva è limitata dal numero massimo di token gestibile dal modello, quindi non è possibile fornire un grande volume di dati come contesto.
L’approccio In-context risolve questo problema fornendo solo le informazioni contestuali sufficienti per rispondere a una specifica richiesta dell’utente, partendo da grandi quantità di dati sorgente. È l’architettura circostante a determinare quali informazioni iniettare.
La forza di questo paradigma, rispetto a tecniche come il fine-tuning o la distillation, risiede nel fatto che non richiede competenze specifiche di AI né costosi training. Inoltre, i modelli oggi vengono forniti come servizio, eliminando completamente la necessità di gestione e deployment.
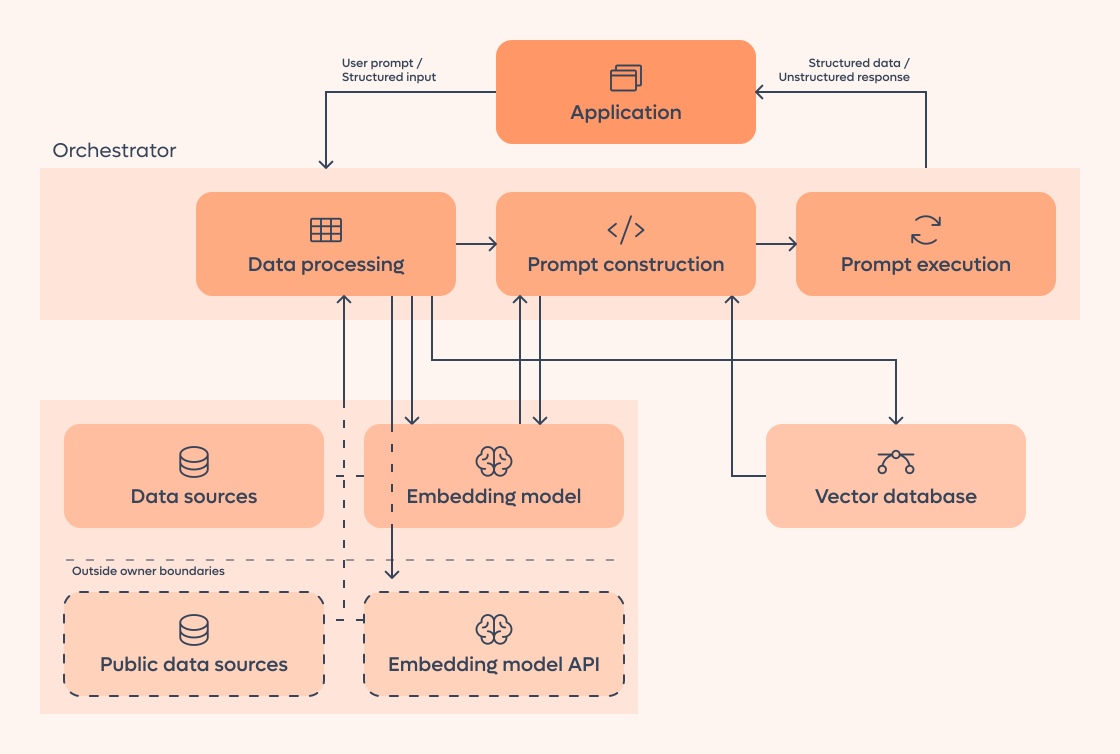
Concettualmente, l’approccio In-context può essere diviso in tre fasi:
- Data preprocessing
- Prompt construction
- Prompt execution
Il data preprocessing comprende il chunking, l’embedding e l’archiviazione di dati privati da usare come informazioni di contesto. Si possono utilizzare fonti eterogenee come documenti di testo, PDF e persino dati strutturati (SQL, JSON). Ogni contenuto viene suddiviso in blocchi e descritto con determinati metadati. Nella fase di embedding, il contenuto passa attraverso un modello LLM di embedding che ne restituisce la rappresentazione numerica (vettore). Infine, questi embedding vengono memorizzati in un database specializzato (ovvero un vector database) che offre primitive efficienti per confronto e navigazione.
Il Prompt Engineering sta diventando sempre più mirato e sofisticato: tecniche complesse come Chain-of-Thought, Automatic Reasoning o Self Consistency possono essere usate per guidare il ragionamento del modello linguistico. La prompt construction è la fase che automatizza queste tecniche e il popolamento dei dati dalla fase precedente. Qui gli agenti possono anche applicare logiche di business personalizzate per modificare o integrare la costruzione del prompt con informazioni esterne (ad esempio chiamando una web API). In maniera “a matrioska”, questi agenti potrebbero essere a loro volta LLM, capaci di decidere autonomamente come modificare il prompt in modo mirato.
Infine, il prompt costruito viene eseguito, e l’output dell’LLM principale è usato per completare le fasi finali delle applicazioni basate su LLM. Tipicamente si applica un post-processing per strutturare i dati prodotti e validarli.
Implementare un’architettura simile non è banale. Fortunatamente esistono framework che orchestrano tutte le fasi e offrono implementazioni pronte all’uso per caricamento dati, storage e interazione con l’LLM. I più noti, che abbiamo deciso di adottare in Buildo, sono LlamaIndex e LangChain: forniscono API semplici da usare che permettono agli sviluppatori di realizzare tutte le fasi descritte con poche righe di codice.
load_dotenv('./.env')
openai.api_key = os.getenv("OPENAI_API_KEY")

# Data Preprocessing
reader = SimpleDirectoryReader(input_dir=SOURCE_DIR_PATH)
documents = reader.load_data()
index = VectorStoreIndex.from_documents(documents)

# Prompt Construction
# ...

# Prompt Execution
query_engine = index.as_query_engine()
response = query_engine.query(sys.argv[1])

print(response)
L’In-context learning non esclude il fine-tuning. È possibile usare qualsiasi LLM, proprietario o open source, fine-tunato o meno. Lo scopo del fine-tuning è specializzare un modello per un caso d’uso di business: può essere estremamente efficace, ma richiede competenze di Machine Learning e costi elevati di training e gestione del modello.
Alcune aziende AI offrono il fine-tuning as-a-Service, riducendo drasticamente questi costi. Tuttavia, l’esperienza in AI deriva da risorse umane che potrebbero non essere già presenti in azienda. In Buildo, ad esempio, abbiamo una base solida di competenze in machine learning, ma con l’AI che avanza così rapidamente stiamo potenziando costantemente il nostro sforzo interno di apprendimento per sviluppare competenze di AI engineering.
Software Engineering: gli LLM in soccorso
Abbiamo visto come i principi di base del Software Engineering abbiano aiutato a creare un framework intorno agli LLM, per integrarli facilmente nelle applicazioni. Ma dove sta il rischio?
Come per ogni nuova tecnologia: l’eccesso. Quando arriva qualcosa di nuovo, noi ingegneri tendiamo — anche sotto la pressione del mercato — a voler includere la novità in qualsiasi soluzione. Inoltre, queste architetture emergenti rendono molto facile integrare gli LLM su ampia scala.
La questione è che la tecnologia LLM risolve problemi specifici che nessun’altra soluzione può affrontare. Al contrario, gli approcci euristici funzionano ancora e sono generalmente più efficienti ed economici.
Di fronte a un problema complesso, è fondamentale affrontarlo prima di tutto con un approccio divide et impera. Identificare i sottoproblemi minimi affrontabili permette di capire meglio come risolverli. Con alta probabilità, la maggior parte dei sottoproblemi è facilmente risolvibile con euristiche. L’AI va usata dove è più efficace o necessaria. Anche se pensiamo che un problema possa essere risolto interamente da un LLM, i passaggi di pre- e post-processing sono i tipici sottoproblemi difficili da individuare che possono essere risolti con metodi euristici, a volte in modo più robusto ed efficiente.
Grazie ai framework citati e alla disponibilità generalizzata di LLM-as-a-Service, usare una strategia a plugin e far interagire tra loro le soluzioni ai sottoproblemi è oggi piuttosto semplice. In questo modo la soluzione complessiva bilancia costi e valore, riducendo il rischio di usare tecnologie eccessive per problemi più semplici.
In Buildo siamo in prima linea nella sperimentazione e nell’evoluzione dei nostri servizi integrando soluzioni AI. Abbiamo avuto la possibilità di collaborare con Superlayer.co, una startup in forte crescita nel settore delle sales pipeline.
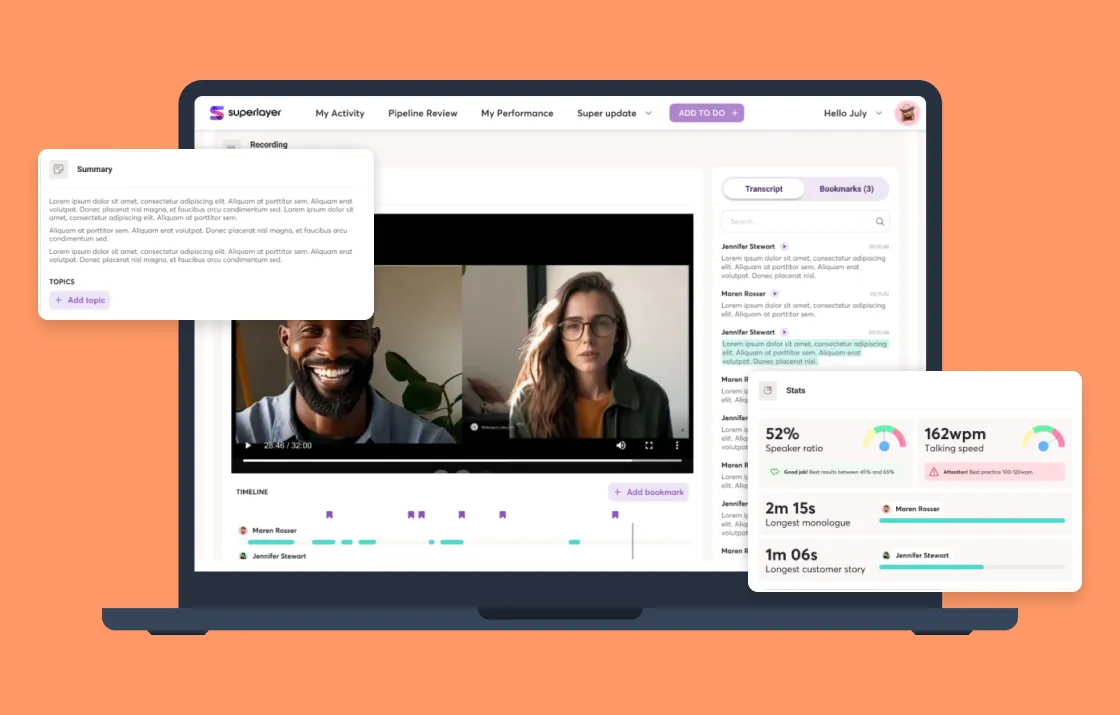
Insieme a Superlayer abbiamo sviluppato una funzionalità di Conversation Intelligence all’interno della loro piattaforma, in grado di:
- Registrare le call di vendita
- Generare trascrizioni delle riunioni
- Fornire business insight intelligenti dalle chiamate
Per gli insight intelligenti abbiamo sfruttato la tecnologia LLM con le tecniche di Prompt Engineering più comuni, così da offrire informazioni solide e utili ai sales representative basandoci sul contesto delle chiamate.
Dai un’occhiata al case study dettagliato qui.
Conclusione
In sintesi, le architetture emergenti intorno agli LLM forniscono alle tecnologie software un potere trasformativo senza precedenti. Le software house come Buildo possono sfruttare l’approccio “In-context learning” per sviluppare funzionalità AI senza competenze avanzate sugli LLM e senza costosi training.
Bisogna però rimanere prudenti per evitare il rischio di eccesso. Suddividere i problemi complessi, utilizzare euristiche e applicare l’AI solo dove porta più valore consente di mantenere un buon equilibrio tra costi ed efficienza.
In Buildo ci impegniamo a sfruttare questi progressi non solo per arricchire i nostri prodotti con funzionalità prima irraggiungibili, ma anche per concentrarci maggiormente sul perfezionamento degli aspetti qualitativi del software engineering.